量化机器学习入门:从特征到可验证的预测
先搞懂特征、Label、时间切分;
再用 18ETF 案例把 LogDiff → PCA50 → Expanding → Lasso 落地。
+ PCA
~1440
50
370
= H
出分
监督学习只要记三件事:特征、Label、模型
中学生例子:体育老师想根据身体情况,猜同学的体能测试分数。
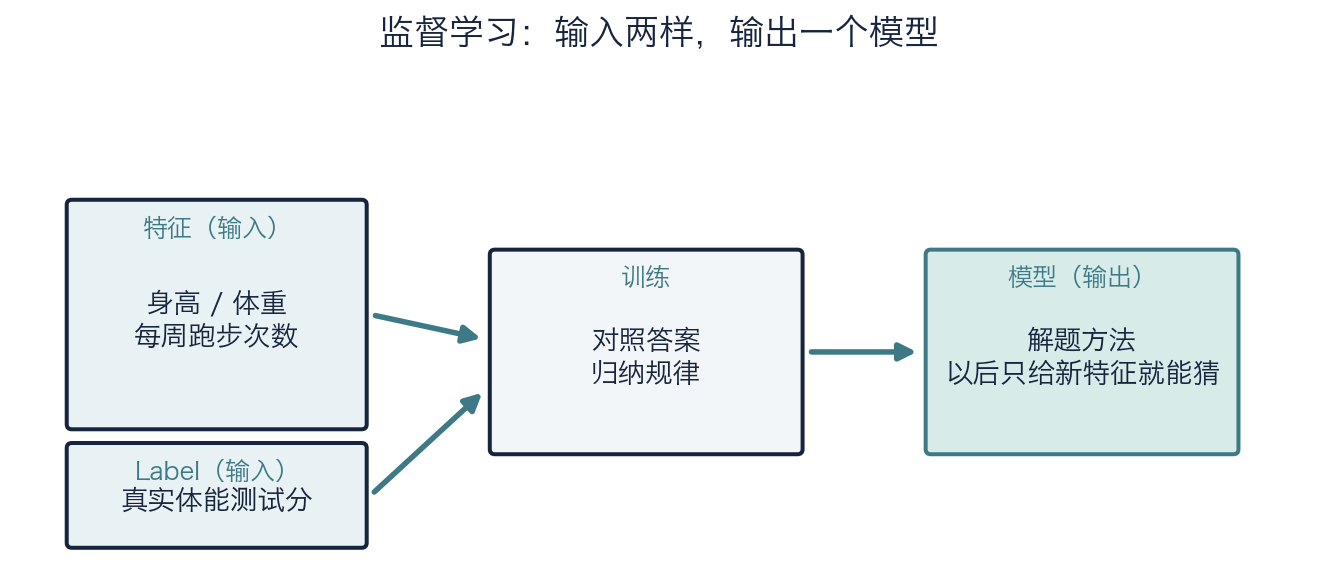
Feature、Label、训练、Prediction + 线性回归 / Lasso
| 概念 | 回答的问题 | 本页要强调 |
|---|---|---|
| Feature | 模型现在看到了什么? | 只能用当时可知信息 |
| Label | 训练时希望模型学会预测什么? | 只在训练阶段当“标准答案” |
| 训练(Training) | 模型怎样从 Feature + Label 学规则? | 不断调系数,让预测误差变小 |
| Prediction | 模型对新数据判断什么? | 仍是预测值,不是交易指令 |
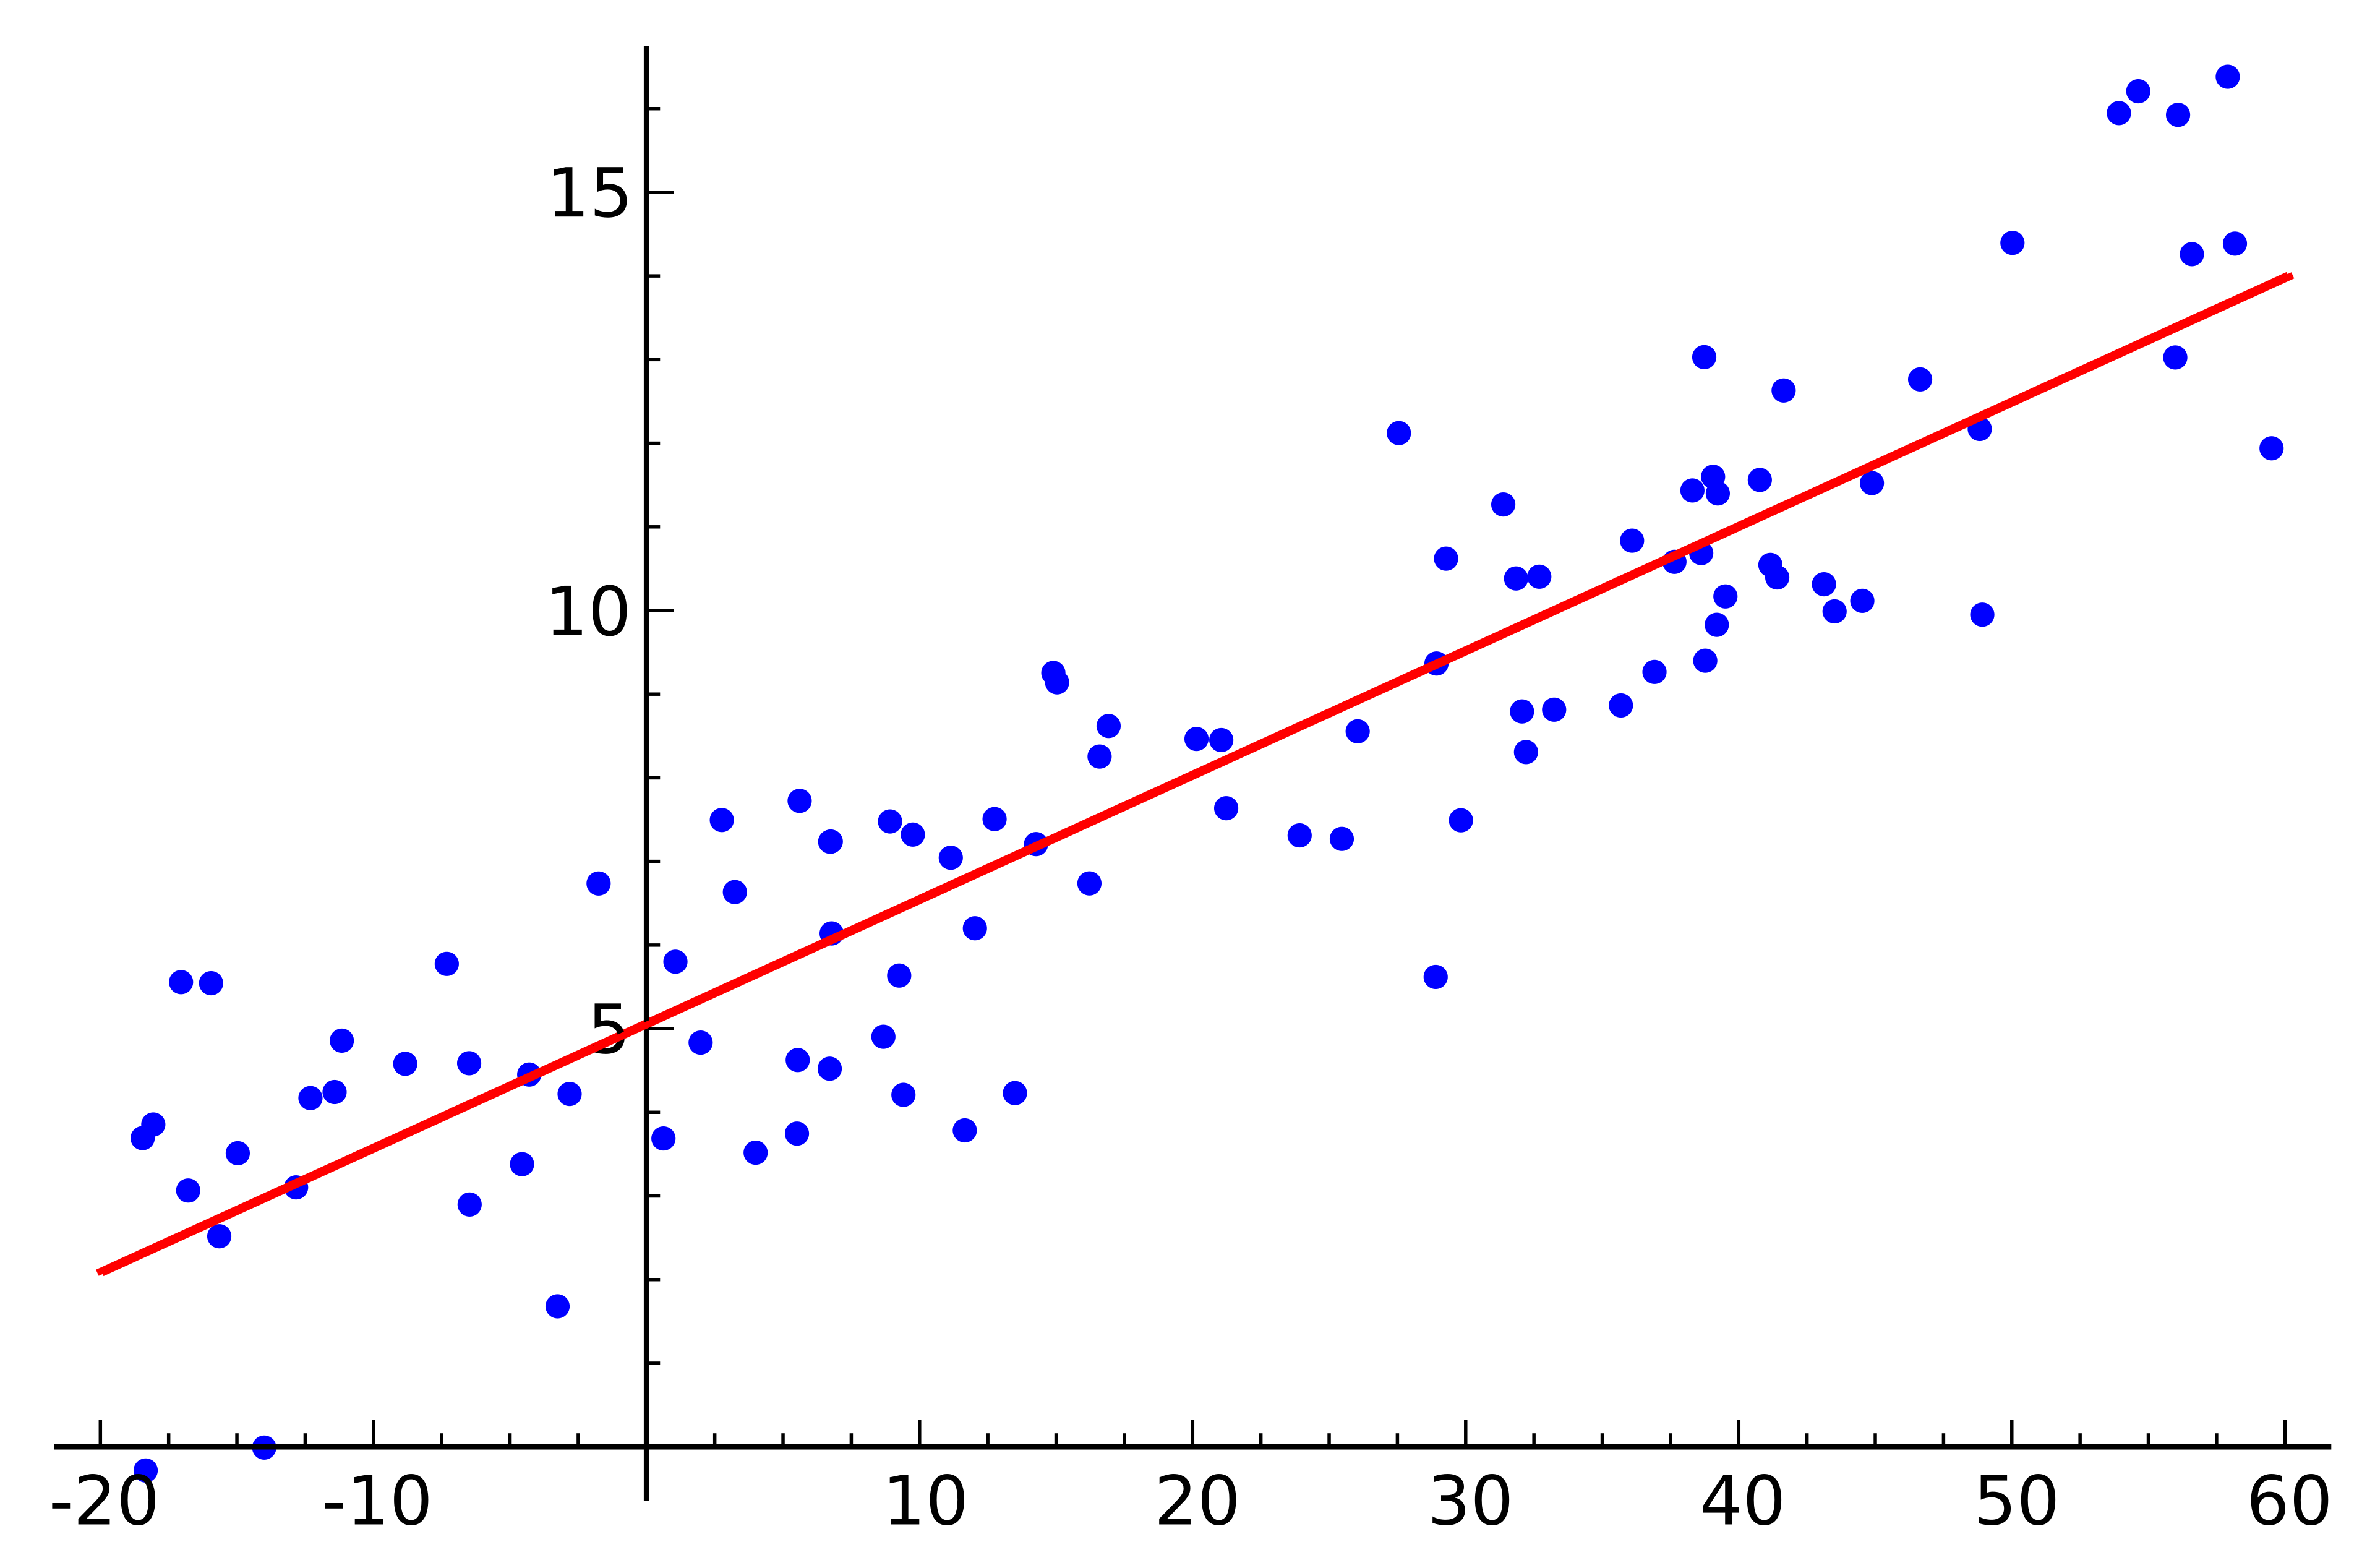
y = f(x):输入 → 规则 → 结果把 x 放进规则 f,就得到结果 y。x 是条件,y 是答案x 例如跑步次数、身高;y 是真实体测分数。f 是规则,ŷ 是模型的猜测训练是在找出 f;预测时用 f(x) 算出 ŷ,去猜真实 y。Feature、Label、训练、预测,怎样接在一起?
X_train + y_train 用于训练;面对新样本时只有 X_new,模型输出 ŷ_new,真实 y_new 留待未来检验。下列哪一项只能当 Label,不能当 Feature?
A. 截至周二的价格与成交量 B. 过去 5 日的波动 C. 周三之后 20 日的实际收益
选 A / B / C,并写一句理由:为什么它在周二收盘时能或不能被看到?
先独立想 30 秒,再点击查看答案。
查看答案收起答案
未来 20 日的实际收益在周二收盘时还没有发生,只能在训练阶段作为答案(Label)。A、B 是当时已经可知的信息,才可以做 Feature。
核心概念
先把对数差分、PCA、Lasso、截面排名、Expanding、Purge 讲清楚
什么是「对数差分」?
日常收益率是 (今天 − 昨天) / 昨天;量化里更常用对数差分,方便跨时间加总、跨品种比较。
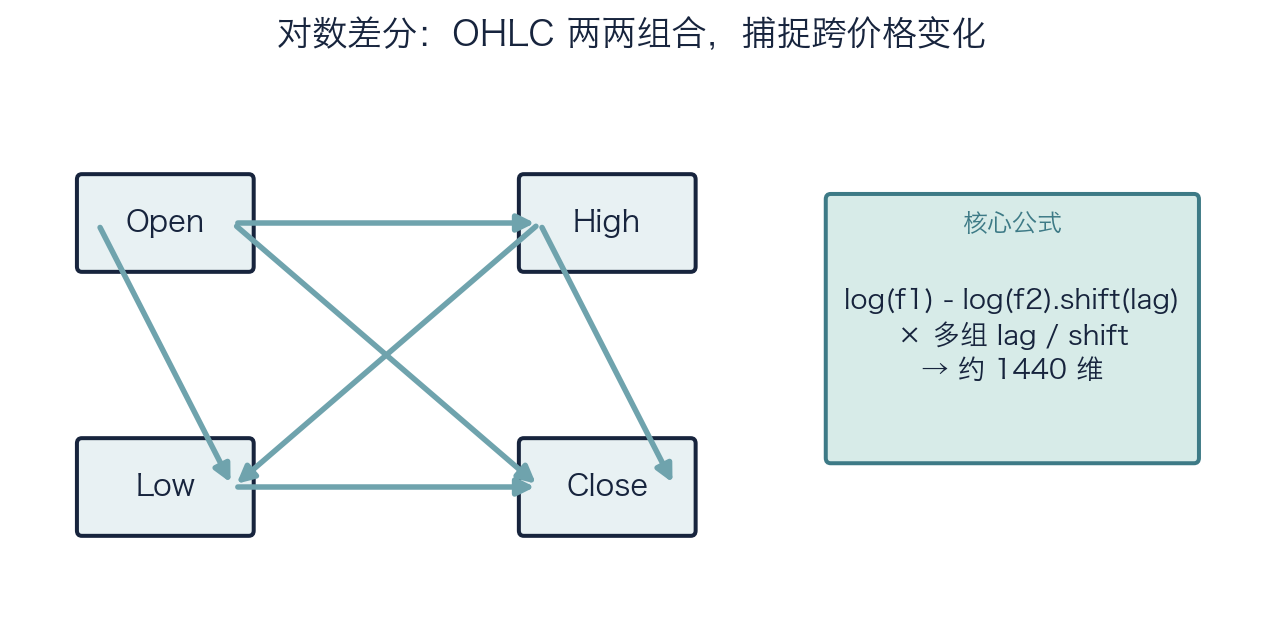
log(f1) - log(f2).shift(lag)1440 个特征,到底是怎样乘出来的?
10 → 11 和 100 → 110,LogDiff 会一样吗?
回答“会”或“不会”,并写一句理由:LogDiff 比较的是价格差,还是相对变化?
先独立想 30 秒,再点击查看答案。
查看答案收起答案
两者都是 +10%,所以都是
log(1.1)。LogDiff 把不同价格量级统一成相对变化,不是直接比较 1 和 10 这两个价格差。PCA:找到数据摊得最开的方向
点云拉成斜椭圆时,先画最长方向的新轴(PC1),再画垂直的次要轴(PC2)。
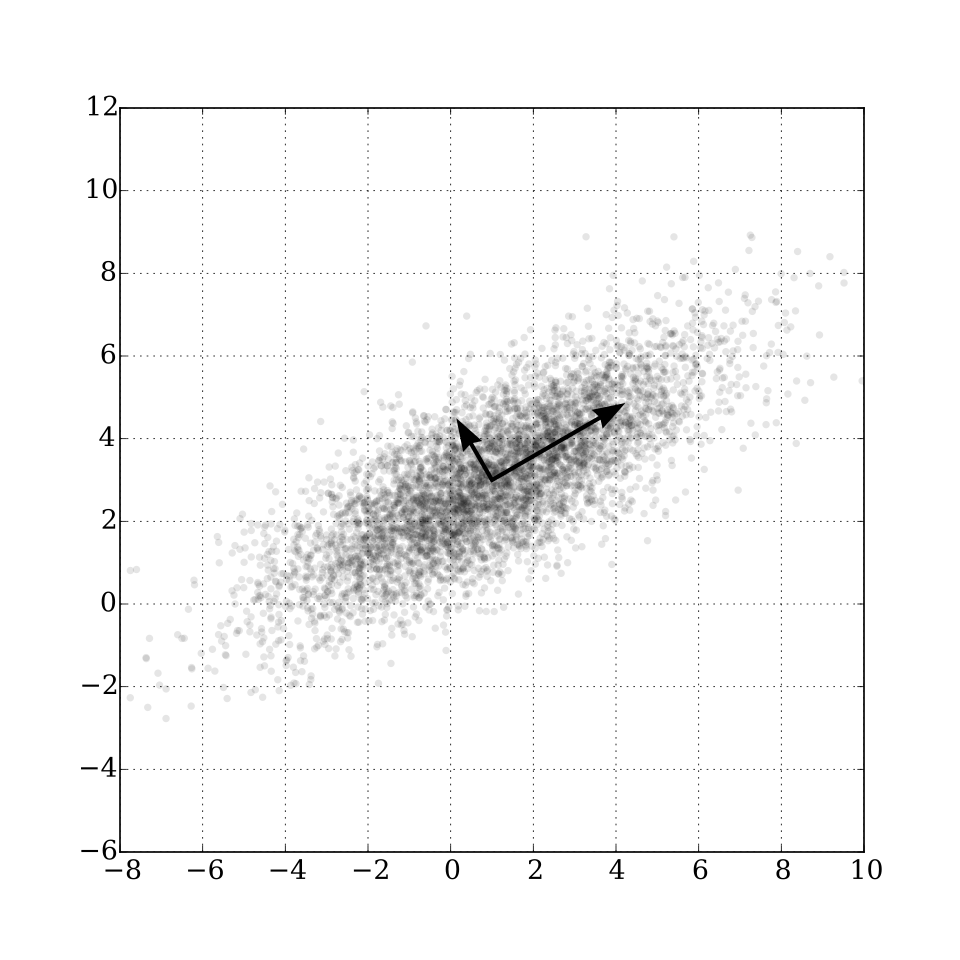
GaussianScatterPCA.svg。案例里会把约 1440 维压到 50 维。为什么 1440 维必须压成 50 维?
fit,再 transform 预测集 → 防止未来信息泄露。fold_metrics_lasso.csv 的 pca_explained_variance_sum(5 折 98.90%–99.00%)。从 3D 投影到 2D / 1D
同一批样本仍保留;PCA 丢弃的是信息较少的坐标方向,并用更少的坐标重新表示它们。
能把预测期的数据一起拿来 fit PCA 吗?
pca.fit(full_X)。这一步能不能做?选“能”或“不能”,并说出原因。
先独立想 30 秒,再点击查看答案。
查看答案收起答案
PCA 会从数据里学习主要变化方向;把 2025 年一起 fit,就让未来分布影响了训练过程。正确顺序是只在训练窗
fit,再对训练窗和预测窗都 transform。OLS:先学一条「误差最小」的直线
把 PCA 后的特征送进模型时,OLS 会找一组系数,让训练样本的预测误差平方和最小。
min Σ(yᵢ − ŷᵢ)²
e = y − ŷ。每个点都要被照顾,不是只让某一个点贴着线。拖动直线,看残差平方和怎样变
先随意移动斜率或截距,再点“回到 OLS 最优直线”:黄色残差加总后平方,最小值就是 OLS 的选择。
同样拟合误差,Lasso 多了一道「系数预算」
两者都希望预测接近真实值;差别在于 Lasso 会同时惩罚所有系数的绝对值之和。
Lasso:min Σ(yᵢ − ŷᵢ)² + αΣ|βⱼ|
αΣ|βⱼ| 像总预算;弱特征不值得花预算时,系数会被压成 0。| 比较点 | OLS | Lasso |
|---|---|---|
| 系数结果 | 通常多数特征都会留下系数 | 弱特征可恰好归零 |
| 模型复杂度 | 以拟合误差为主 | 用少量有效特征换取更简洁的模型 |
| 本课角色 | 理解 Lasso 的无约束基线 | 唯一正式训练的模型 |
Lasso:给系数设一个「总额度」
普通线性回归给 50 个主成分都配一个系数;Lasso 额外要求「所有系数的绝对值之和不能太大」,装不下的就只能归零。
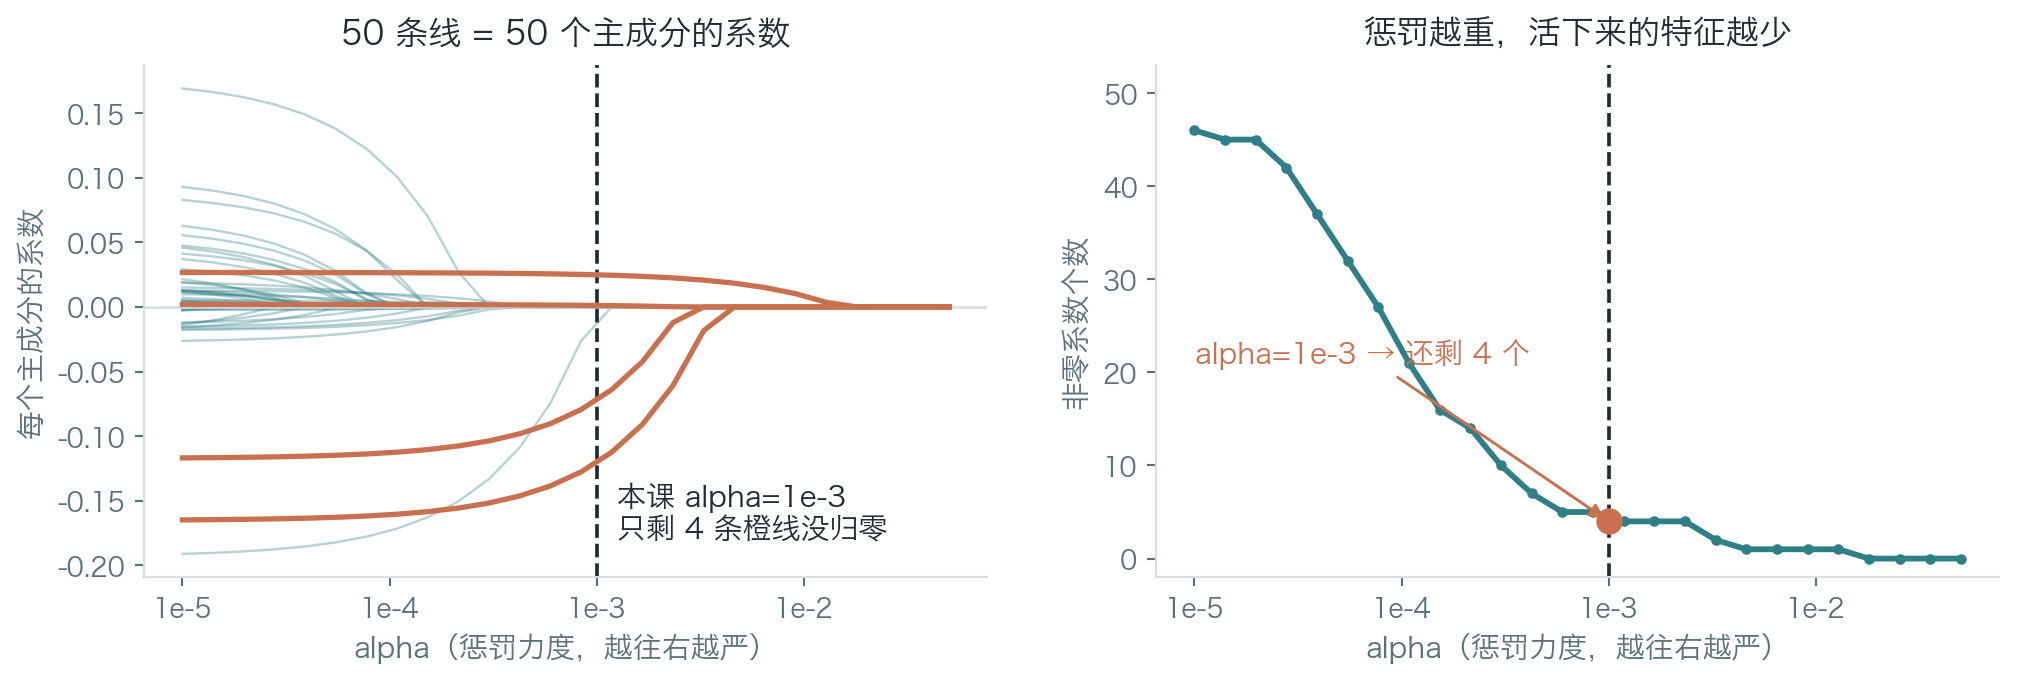
lessons/legacy-slides/ppt/lesson_07/make_figures.py 在本课最后一折真实训练数据上跑出来,不是示意图。把 alpha 调大,看弱系数何时归零
用一个可控的示意路径,把“正则化更强 → 模型更稀疏 → 可能欠拟合”的关系看清楚。
把 alpha 调大后,弱系数会怎样?
alpha 从很小的值逐步调大。弱特征的系数更可能“变大”,还是“被压到 0”?写一句理由。
先独立想 30 秒,再点击查看答案。
查看答案收起答案
alpha 越大,Lasso 对系数总量的限制越强,弱特征会先归零,因此它同时在做稀疏化和特征筛选。太大时,连有用特征也可能被删掉。截面排名是 Label:给模型的「标准答案」
每个交易日先看未来 20 日实际收益,再把同日 ETF 排成 [0,1];这个排名只在训练时当作 y(Label)。
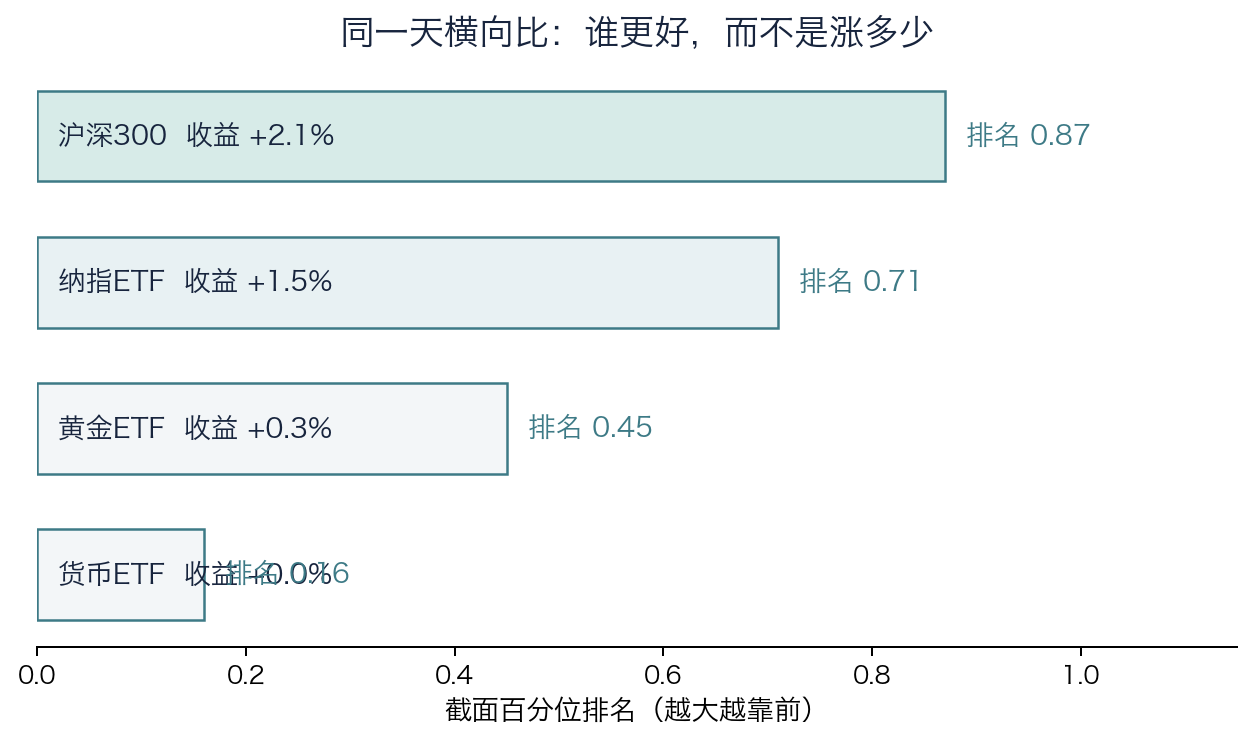
截面排名在本课里,是 Feature、Label,还是仓位?
这个截面排名应归为哪一项?选 Feature / Label / 仓位,并写一句理由。
先独立想 30 秒,再点击查看答案。
查看答案收起答案
它依赖未来 20 日的实际收益,在周二收盘时还不存在,因此只能作为训练答案。Feature 是周二已经可知的信息;Lasso 的预测分数才会在下一步被用于排序,二者都不是仓位本身。
Expanding:训练窗只往前长,不丢历史
市场会变,不能只训一次;但也不扔掉旧数据——历史越积越多。
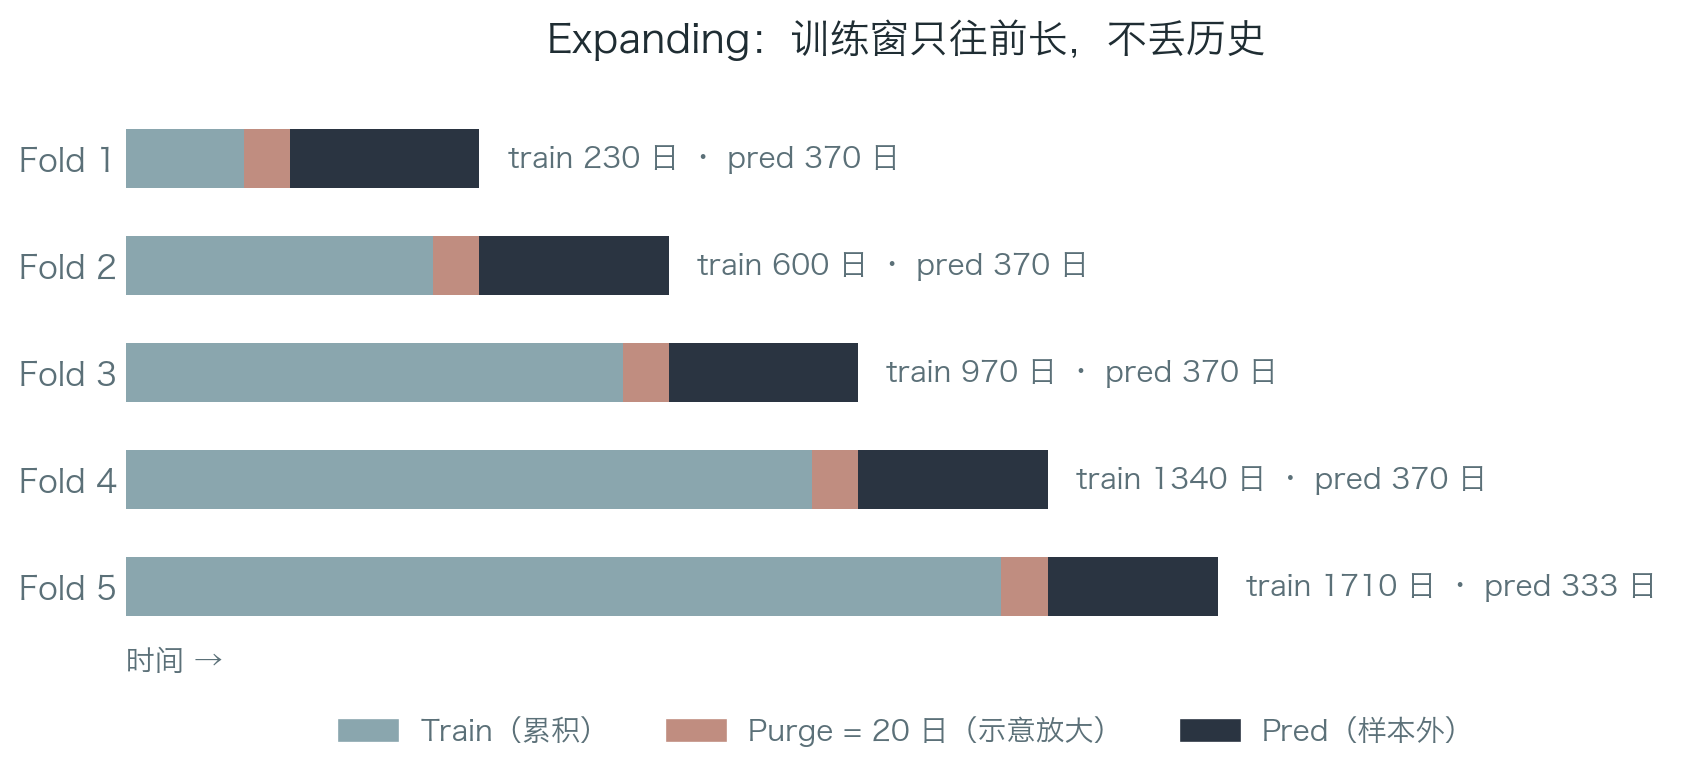
retrain_step 调小 → 折数变多、重训更频繁、跑得更慢;本课工作流默认 370。策略逻辑
18ETF × LogDiff × PCA50 × Expanding × Lasso
本课在预测什么?整条链长什么样?
全球资产池
horizon=20 日收益排名可能更高?| 项目 | 本课口径 |
|---|---|
| 特征 | OHLC 对数差分 4×4×9 lag×10 shift = 1440 维 |
| 降维 | PCA → 50(只在训练窗 fit) |
| 模型 | Lasso(alpha=1e-3)(本课只用这一个) |
| 标签 | 未来 20 日收益的截面 percentile rank |
| 训练 | Expanding:min_train=250 / retrain_step=370 / purge=20 |
每一折都先训练,再预测
把数据准备与 Lasso 出分交给 AI
推荐 Prompt 要点
- 读取 18 ETF 的
1d_adj日线(已复权,不要二次调整)。 make_logdiff_panel_features(panel)拼出 1440 列。- 生成
horizon=20截面 Rank Label,剔除尾部不完整样本。 - Expanding:
min_train=250, retrain_step=370, purge=20。 - 每折 train-only
PCA(50),再 fitLasso(alpha=1e-3)。 - 报告维数、解释方差、非零系数、折外 MSE / R² / Rank IC。
Lasso 给出最高分,就能直接买入吗?
此刻能不能直接下单买 A?选“能”或“不能”,并指出模型当前只完成了哪一步。
先独立想 30 秒,再点击查看答案。
查看答案收起答案
本课的模型只完成“预测并排序”,输出的是分数。把分数变成 Top N、权重、调仓和含成本回测,是后续的组合与执行问题。
验收:LogDiff → PCA → Expanding → Lasso
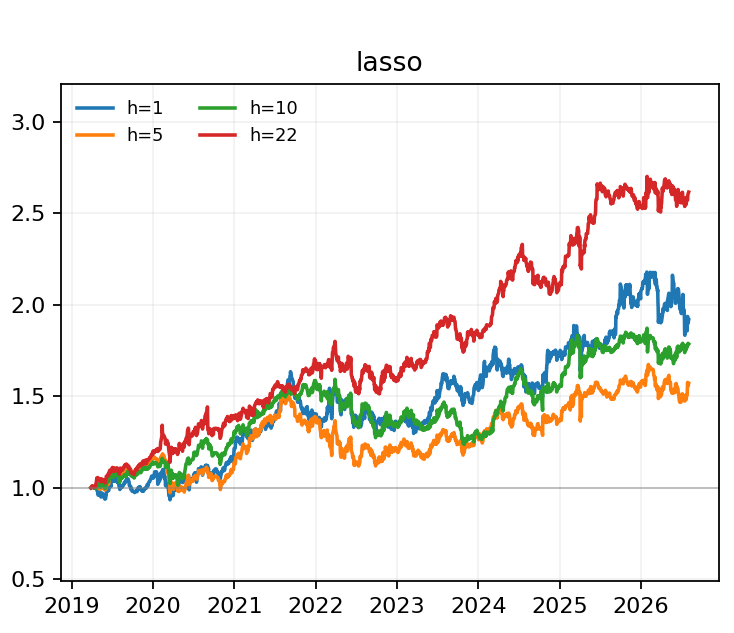
固定 Lasso,比较 PCA 维数下的策略绩效
使用本课的 Lasso 工作流三次。每次只改变 PCA 维数;训练、验证与回测设置保持一致。
实验 A:Lasso + PCA 20
实验 B:Lasso + PCA 50
实验 C:Lasso + PCA 100