第 8 课 · 随机森林 / XGBoost

树模型如何协同做预测

第 7 课的数据链原样不动;
只把最后那个估计器从 Lasso 换成随机森林与 XGBoost,看会发生什么。

承接 18ETF LogDiff → PCA50 → Expanding 链路 · 报告根 reports/lesson_07_etf18_horizon_sensitivity/
树的
集成
决策树
Bagging
并联
Boosting
串联
Top3
等权
回测
对照
进入正题 · 目录

目录:先讲清两种树模型,再接回策略

第一部分 核心概念(本课新增)
  1. 决策树:一串是非题
  2. 随机森林:单树方差大 → 并联 + 两处随机
  3. XGBoost:串联 + 学残差
  4. 两者对照与关键超参
第二部分 策略逻辑(换估计器)
  1. 唯一变量:只换估计器
  2. Score → Top3 等权权重
  3. 交给 AI 跑三模型对照
  4. 验收:净值、Sharpe、换手
  5. 结论:更复杂 ≠ 更好
LogDiff、PCA、截面 Rank Label、Expanding + Purge 已在第 7 课讲完,本课不再重复,直接复用。
第一部分

核心概念

决策树 → 随机森林(Bagging)→ XGBoost(Boosting)

互动图解 · 从线性模型走向树模型

同一批样本,为什么直线和树的预测不一样?

先把 x 放在切分点左边,再拖过阈值:直线平滑变化,树换到另一片叶子、预测跳一档。单独打开 ↗

1 · 决策树

决策树:把预测拆成一串是非题

PC3 > 0?
├── 是:PC1 高吗?
│   ├── 是 → 分数较高
│   └── 否 → 分数中等
└── 否 → 分数较低
一棵树 = 一串「如果…那么…」每个节点问一个是非题,把样本切成越来越纯的小组;落到同一片叶子的样本,给同一个预测值。
树不需要你先想好公式它自己找切分点,天然能表达「涨得太多就不追」这类拐弯关系;若只输入同一个原始特征,OLS/Lasso 的预测是一条直线。
本案例里树切的是 PC分裂条件不是「均线上穿」,而是 PC3 > 0 这样的主成分取值——PCA 之后特征已经没有直观名字了。
树越深,叶子越小,最后每片叶子只剩一两个样本——那已经不是「学会了」,而是「背下来了」。
互动图解 · 紧接上一页

决策树怎样一层层判断?

调整 PC3、PC1、PC2,沿高亮路径逐层判断;有的路径还会进入第 3 层,最后都落入一片叶子。 单独打开 ↗

2 · 随机森林 · 从单棵树的问题说起

一棵深树会把噪声当成规律

训练集中的一个异常点被深树切成单样本叶子;相近的新样本也落入这片叶子,预测 0.95,而事后实际值为 0.20
问题在哪单样本叶子把偶然噪声当成规律。
怎么发现训练误差低,折外预测却可能失准。
怎么约束限制深度,增大叶子最小样本数。
一个噪声点就能让叶子预测从 0.20 跳到 0.95,这正是单树高方差的直觉。图中数字为教学合成示例。查看保留的原图 ↗
2 · 随机森林 · 先理解平均为什么有效

为什么很多棵树取平均,会比一棵树更稳?

先把每棵树想成一名独立猜糖果数量的同学:我们不押宝某一个人,而是把所有人的答案平均。
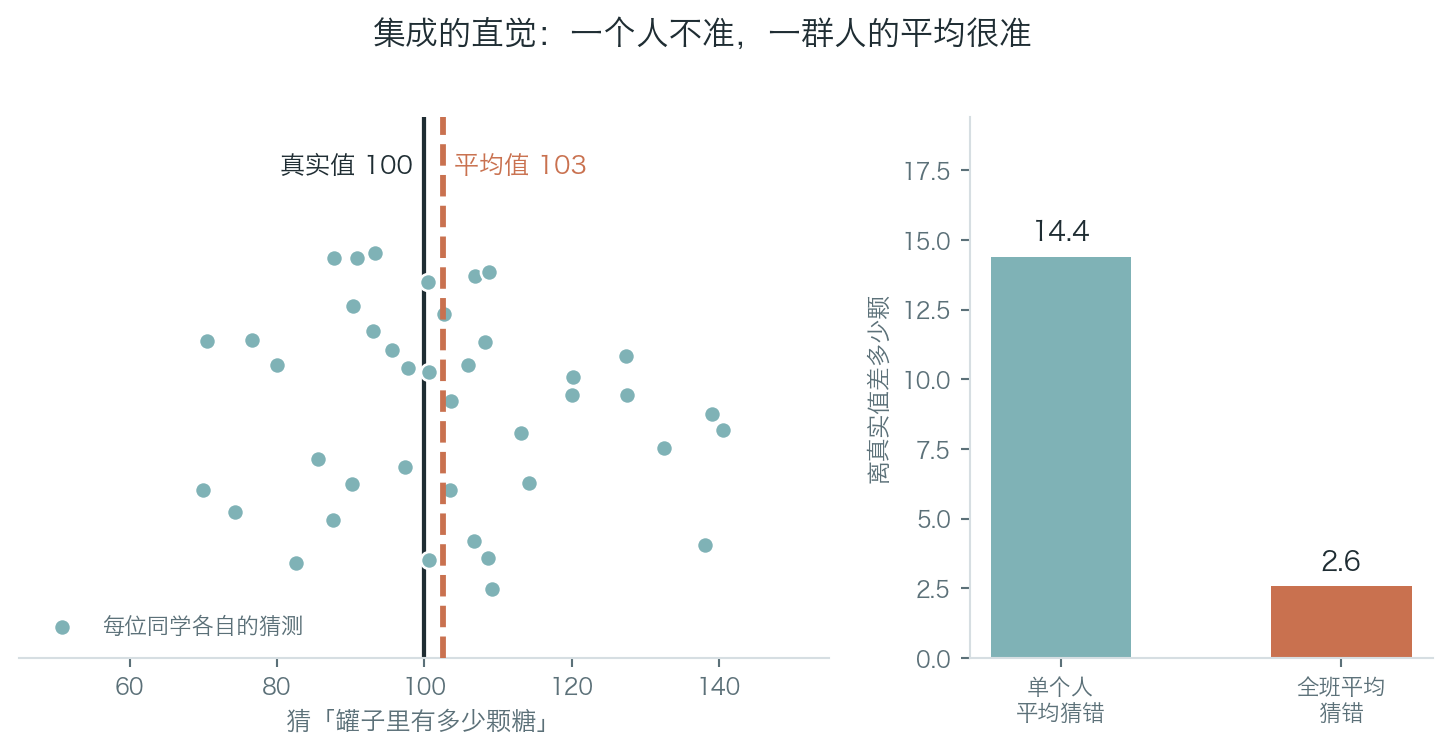
个人猜测误差大,全班平均接近真实值
单个判断容易偏有人猜多、有人猜少,单看一个人的答案,误差可能很大。
平均能抵消随机误差偏高和偏低互相抵消,留下大家共同看见的部分,所以结果更稳定。
关键是「各猜各的」如果所有人都抄同一个答案,错误方向完全一样,平均再多人也没有用。
换成随机森林每名同学就是一棵决策树;森林先让树彼此不同,再把回归预测取平均。
随机森林不是让一棵树变聪明,而是让很多棵犯不同错误的树互相抵消。
2 · 随机森林 · Bagging

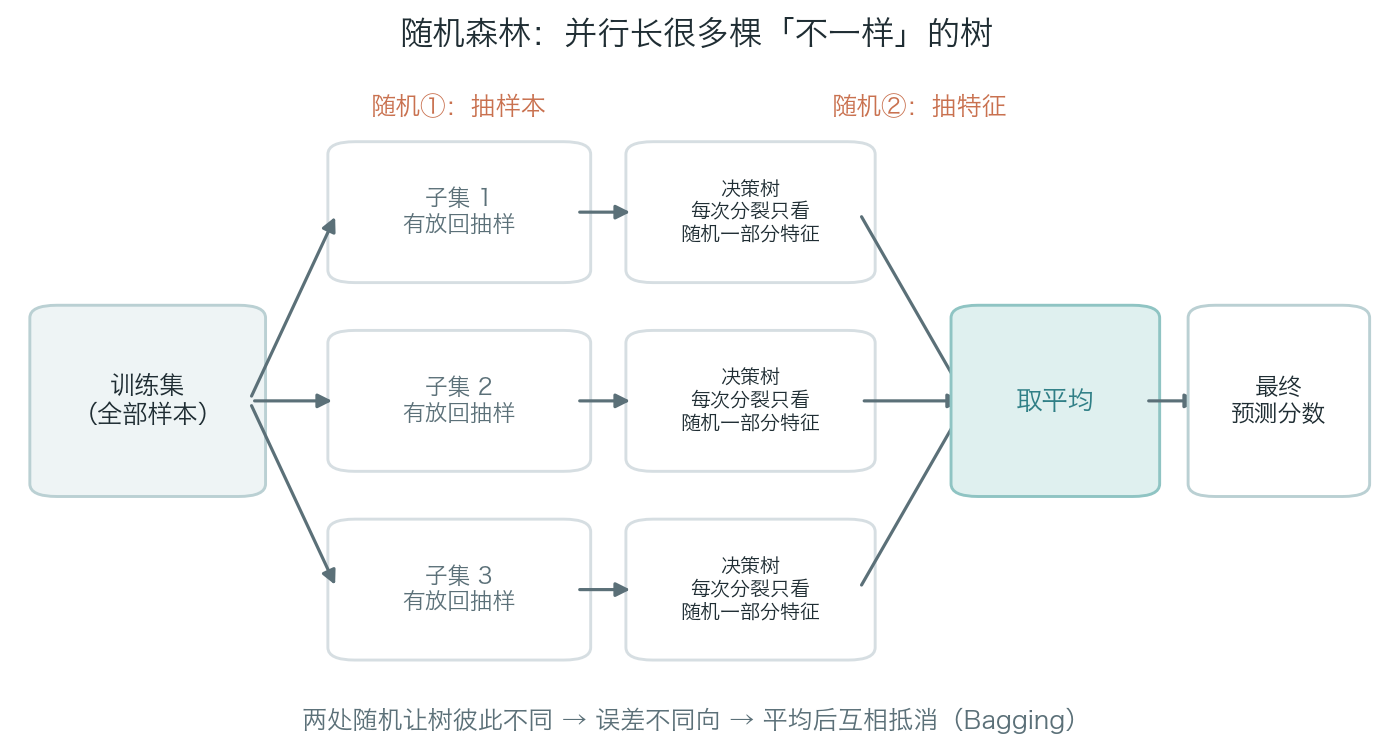
随机森林:并联很多棵「不一样」的树

Bootstrap 行采样与分裂时随机选特征,多树并行后取平均
随机①:抽样本每棵树用有放回抽样得到的子集训练,约 1/3 样本没被抽到。
随机②:抽特征一般可在随机一部分特征里挑;本课 max_features=1.0,每次分裂可看全部特征。
为什么必须不一样树之间越相关,平均的降噪效果越弱;本课主要靠有放回抽样制造差异。
怎么汇总分类取投票,回归取平均;本课预测的是 Rank 连续分数,用平均
2 · 随机森林 · 机制与超参

随机森林:从重抽样到平均分数

① 同一训练集A · B · C · D · E · F 每棵树独立有放回抽 6 次;以下均为合成示意。
② 树 1A A C D F F
B、E 未抽到
score 0.62
② 树 2B C C D E F
A 未抽到
score 0.48
② 树 3A B D E E F
C 未抽到
score 0.55
③ 回归取平均(0.62 + 0.48 + 0.55) ÷ 3 = 0.55 实际本课用 200 棵树;score 是排序分数,不是收益率。
n_estimators = 200树数增加不保证验证收益改善。
max_depth = 6 · min_samples_leaf = 5限制单树复杂度和叶子大小。
max_features = 1.0本课分裂时全部特征可参选;差异主要来自 bootstrap。
随机特征是一般机制;本课工厂没有启用特征子采样。分数只演示平均过程。
互动图解 · min_samples_leaf

每片叶子至少装几个样本,别让树追着异常点跑

紫线=一棵树的预测分数;绿线=41 棵树对同一输入的预测取平均。先调到 1,再调到 5,看异常点附近的紫线怎样变化。单独打开 ↗

理解检查 · 随机森林:并联与平均

所有树都朝同一方向猜错,多加树能消掉这个错误吗?

一片森林从 50 棵加到 200 棵,但树的预测误差高度相关。

回答“能 / 不能”,并说出平均为何在这里失效。

先独立思考 30 秒,再点击查看答案。

查看答案收起答案
不能。平均能抵消方向不同的随机误差;共同错误会被一起保留下来。要检查树之间的相关性和差异来源。
3 · XGBoost · Boosting

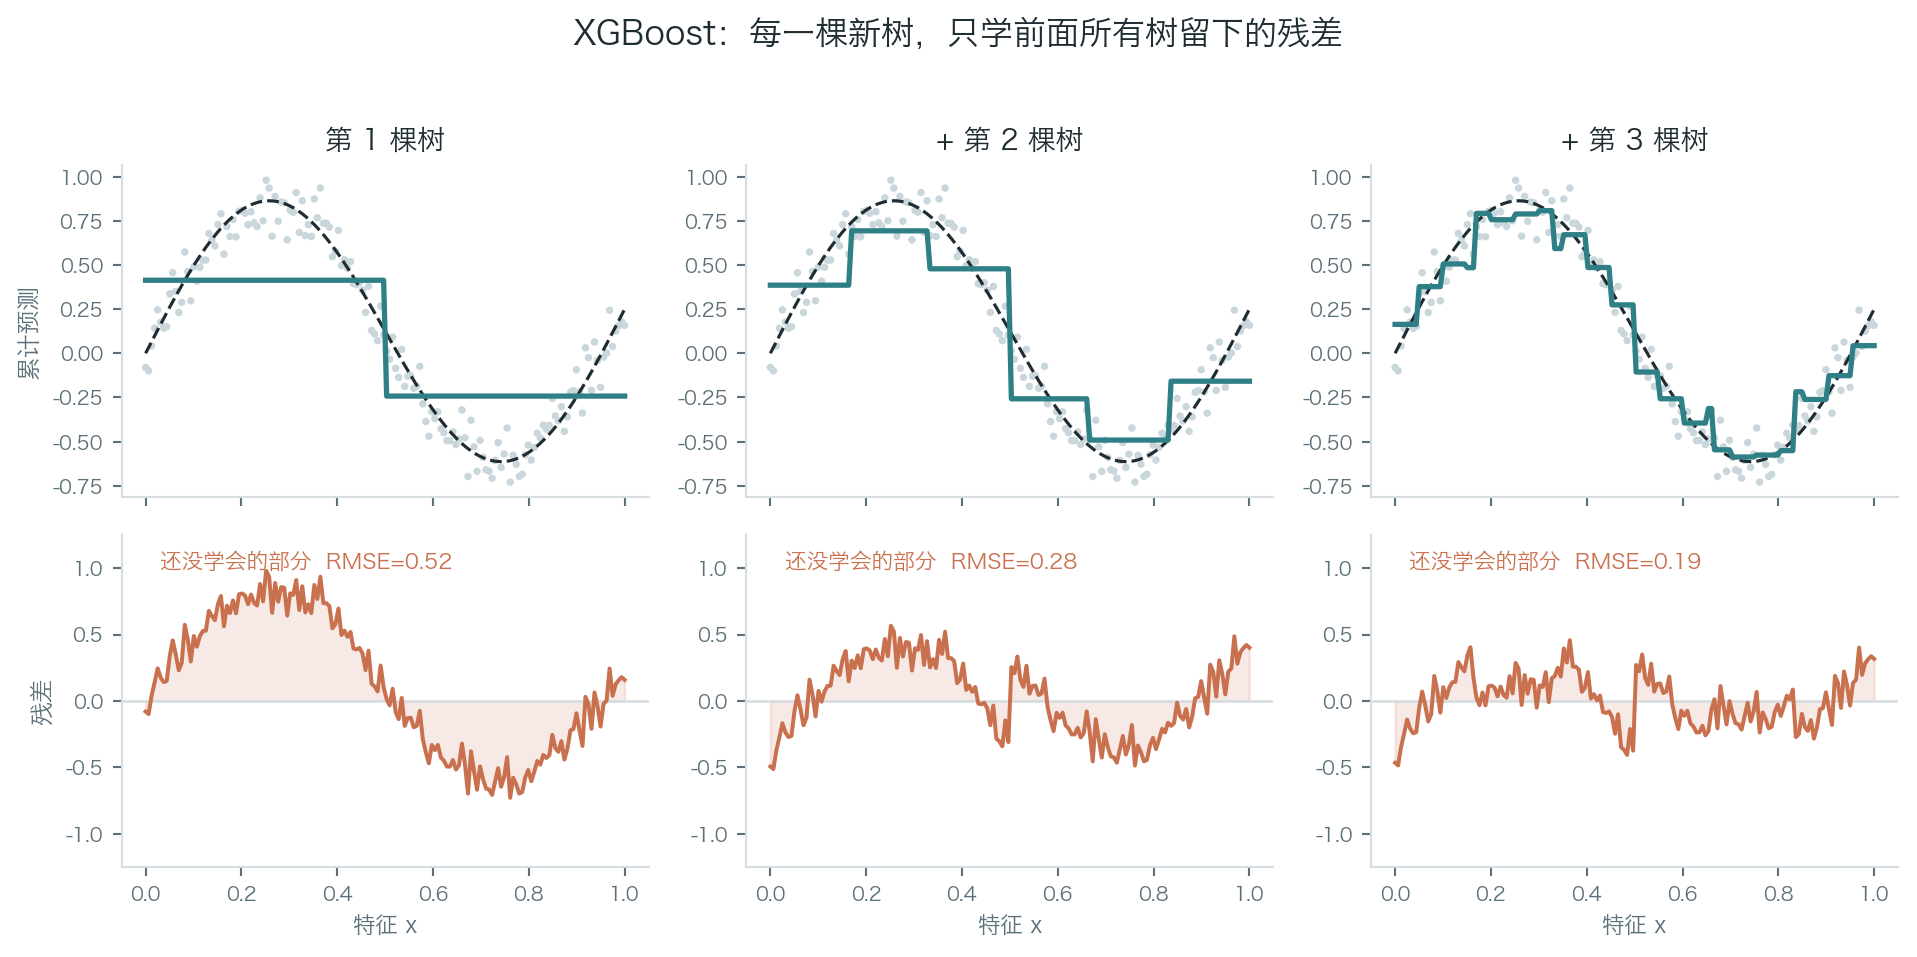
XGBoost:串联,每棵新树专门补上一棵的错

三轮 boosting:累计预测逼近真实曲线,残差逐轮缩小
上排:累计预测从一条粗糙的阶梯开始,越加越贴近真实曲线。
下排:还没学会的部分残差 RMSE 0.52 → 0.28 → 0.19,新树只针对它训练。
每棵树都很浅单棵是「弱学习器」,靠数量和顺序取胜,不靠单棵聪明。
顺序不能打乱第 3 棵必须看过前两棵的结果,所以树之间无法并行。
互动图解 · 紧接上一页

Boosting 怎样一轮轮修正残差?

单步或播放,改变学习率,观察累计预测、残差和训练 RMSE。
大白话:学习率就是控制每棵新树把预测改动多少的旋钮:调小每轮只改一点,调大每轮改得更多。 单独打开 ↗

3 · XGBoost 续 · 叶分数与正则

XGBoost:每棵树贡献一小步

起点F₀ = 0.70已有预测
第 1 棵叶分数+0.40× 0.05 → +0.02
第 2 棵叶分数−0.20× 0.05 → −0.01
累计预测0.710.70 + 0.02 − 0.01
训练目标:预测误差 + γ × 叶子数 + λ/2 × 叶分数平方和。γ 抑制无谓分裂,λ 压小叶分数;两者都不是 Lasso 的 L1 惩罚。
这里是讲解加法的合成例子;真实 XGBoost 用梯度、二阶信息和正则决定每轮更新。
learning_rate = 0.05每轮修正只走一小步。
n_estimators = 80轮数增多仍须时间验证。
max_depth = 2限制单轮树的复杂度。
subsample = colsample_bytree = 0.9限制每轮样本与每棵树特征比例。
参数来自 skills/ml/pca_fold.py::make_regressorgammareg_lambda 未在工厂显式设置。
4 · 一页对照

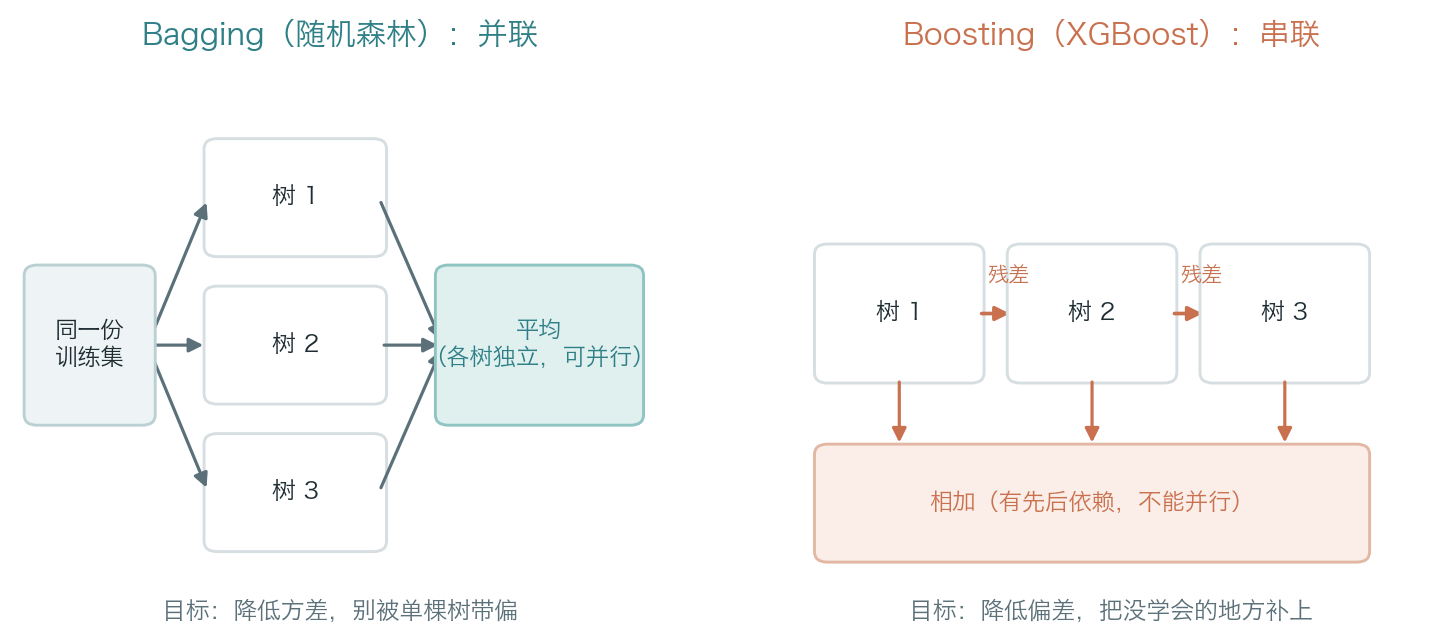
Bagging 与 Boosting:并联降方差,串联降偏差

维度Lasso(第 7 课基线)Random ForestXGBoost
结构一条直线 + L1 稀疏多棵深树并联取平均多棵浅树串联相加
每棵树看到的bootstrap 样本;可选随机特征前面所有树留下的残差
主要解决选出少量有用方向方差(别乱抖)偏差(补上没学会的)
树变多会怎样平均波动趋稳,验证表现仍须检查可能开始过拟合
能否并行可以,树之间独立轮次依赖;轮内可并行
本课角色对照基线bagging 代表boosting 代表
互动图解 · 三种防过拟合的办法

线性模型和树模型,分别在限制什么?

分别调三个旋钮:Lasso 的系数缩小或归零;随机森林的候选分叉被人数门槛拦住;XGBoost 的新增叶子要先抵过罚分。单独打开 ↗

理解检查 · XGBoost 与两种集成方法

下一棵树要专门修正上一棵的错误,该用哪种结构?

现在希望第 2 棵树看过第 1 棵的预测后,再学习它留下的错误。

选择“并联 Bagging / 串联 Boosting”,并写一句理由。

先独立思考 30 秒,再点击查看答案。

查看答案收起答案
串联 Boosting。后一轮依赖前一轮的累计预测与剩余误差;Bagging 的树各自训练,最后再平均。
第二部分

策略逻辑

同一条数据链,只换估计器 → Top3 等权 → 回测对照

5 · 唯一变量

前面全部照搬第 7 课,只换中间那一格

第 7 课已完成PC1…PC50LogDiff 1440 维
train-only PCA
本课唯一变量估计器Lasso / RF / XGBoost
输出score折外预测分数
组合Top3 等权score 转权重
评价回测含成本与换手
for name in ("lasso", "rf", "xgboost"):
    model = make_regressor(name)      # 唯一变化的一行
    model.fit(pc_train, rank_label)   # 同一折、同一份 PCA 变换
    score = model.predict(pc_pred)
不变的部分18 只 ETF、1440 维 LogDiff、截面 Rank Label、Expanding + Purge、train-only PCA50——全部沿用第 7 课。
变的部分只有 make_regressor 返回的估计器;三模型还共享同一份折内 PCA 变换。
只有唯一变量在变,结果差异才能归因到模型本身;否则「XGBoost 更好」可能只是因为它偷偷换了别的东西。
6 · Weight 正式登场

分数不是仓位:先排队,再等权

模型输出score只比同一天的相对高低
当日横向比按分数排序从高到低
选谁Top 3前三名入选
买多少各 1/3其余为 0
教学例子ABCD
模型 score0.900.800.600.20
目标权重1/31/31/30
score 0.90 不是“预计涨 90%”;目标权重持有到下次调仓。并列、缺失分数的处理须按实际实现记录。
理解检查 · 策略:从分数到权重

分数最高的标的,在 Top2 等权里要买得更多吗?

同一天四只 ETF 的 score 为 A=0.90、B=0.60、C=0.59、D=0.10,策略设为 Top2 等权。

写出 A、B、C、D 的目标权重,并说一句理由。

先独立思考 30 秒,再点击查看答案。

查看答案收起答案
A=1/2,B=1/2,C=0,D=0。score 只决定名次;Top2 等权规定入选者各占一半,分数差距不决定仓位大小。
7 · 把研究交给 AI

把四模型对照任务交给 AI

推荐 Prompt 要点

  1. 沿用第 7 课的 18ETF LogDiff + PCA50 + Expanding 协议,不要改数据链。
  2. 在同一批折上分别训练 ols / lasso / rf / xgboost
  3. 四个模型共享同一份折内 PCA 变换,不得各算各的。
  4. Top N=3 等权生成权重,交 VectorBacktester,含佣金 2bp + 滑点 3bp。
  5. 同时报告 ML 指标(Rank IC)与回测指标(Sharpe、回撤、换手)。
  6. 禁止用测试折挑参;事实与推断分开写。
必须讲清
折次一致:四个模型必须用同一批 Expanding 折。
不偷看:PCA / Scaler 不得在预测折 refit。
结果分层:ML 指标与回测指标分开报,不合成一个数字。
AI 实验 · 验收 ①

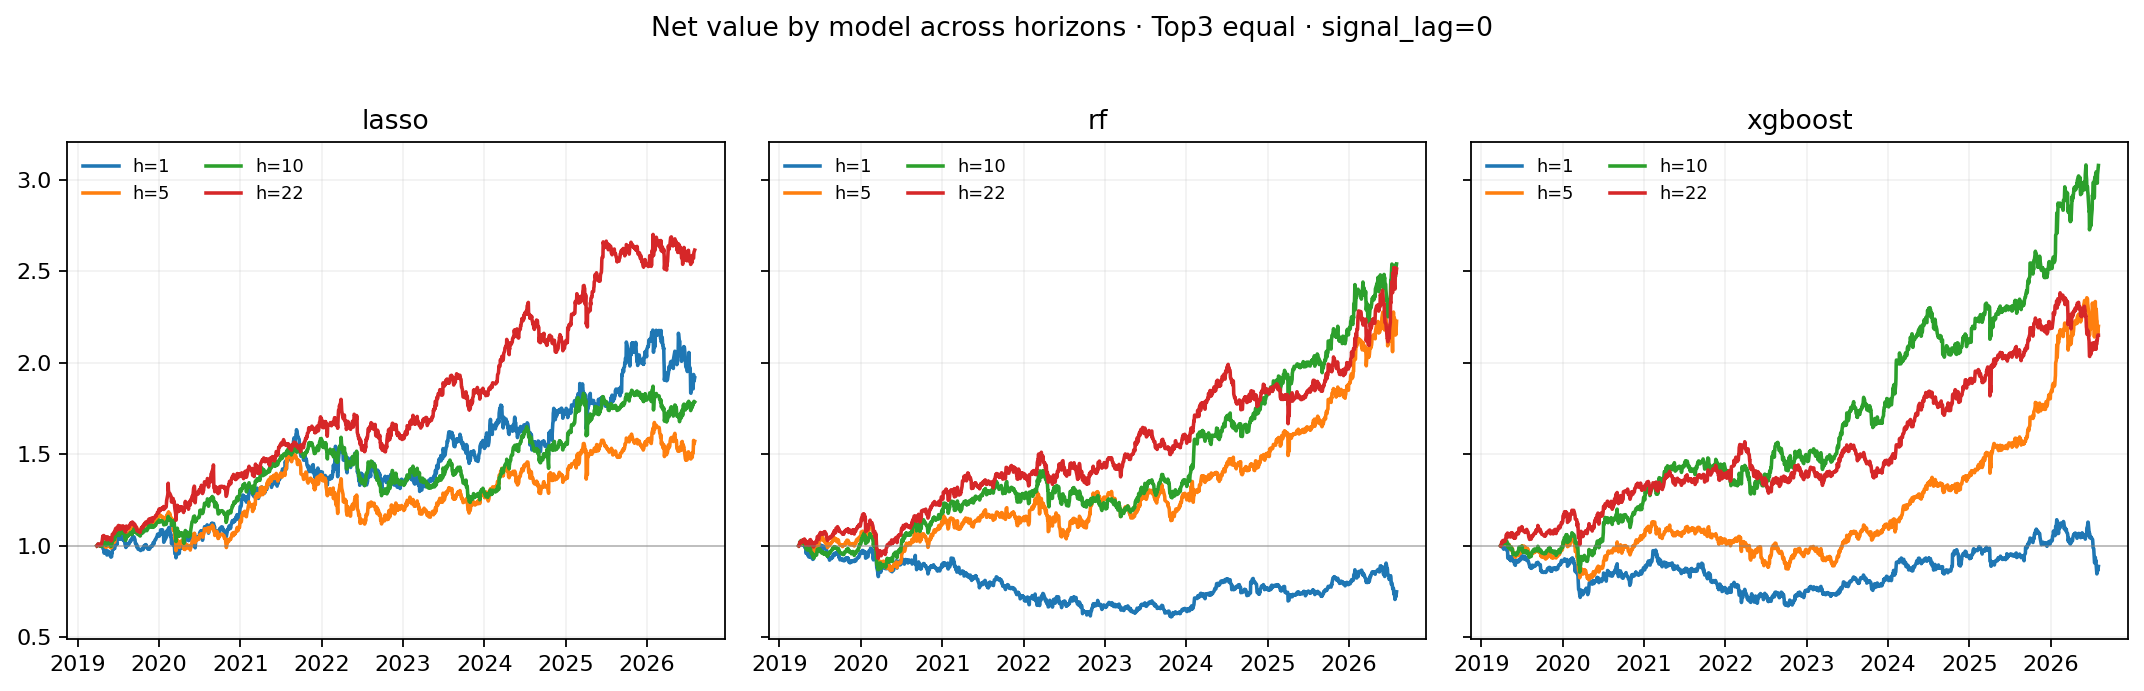
验收:三个模型 × 四个预测跨度的净值

Lasso / RF / XGBoost 在 h=1/5/10/22 下的样本外净值
每一格是一个模型格子里四条线是四个预测跨度:h=1 蓝、h=5 橙、h=10 绿、h=22 红。
Lasso:四条线都在涨最强的是 h=22(红),年化 14.1%、Sharpe 1.09。
RF / XGBoost:h=1 是亏的蓝线一路走低,最后收在 0.76 与 0.89;跨度越短噪声越大,树模型最先崩。
先看格子内,再看格子间同一模型跨 horizon 的差距,明显大于同一 horizon 跨模型的差距。
口径:Top3 等权、signal_lag=0、佣金 2bp + 滑点 3bp、purge=horizon、PCA50 train-only;样本外 2019-03 至 2026-08。
AI 实验 · 验收 ②

换个预测跨度,排名就换了一遍

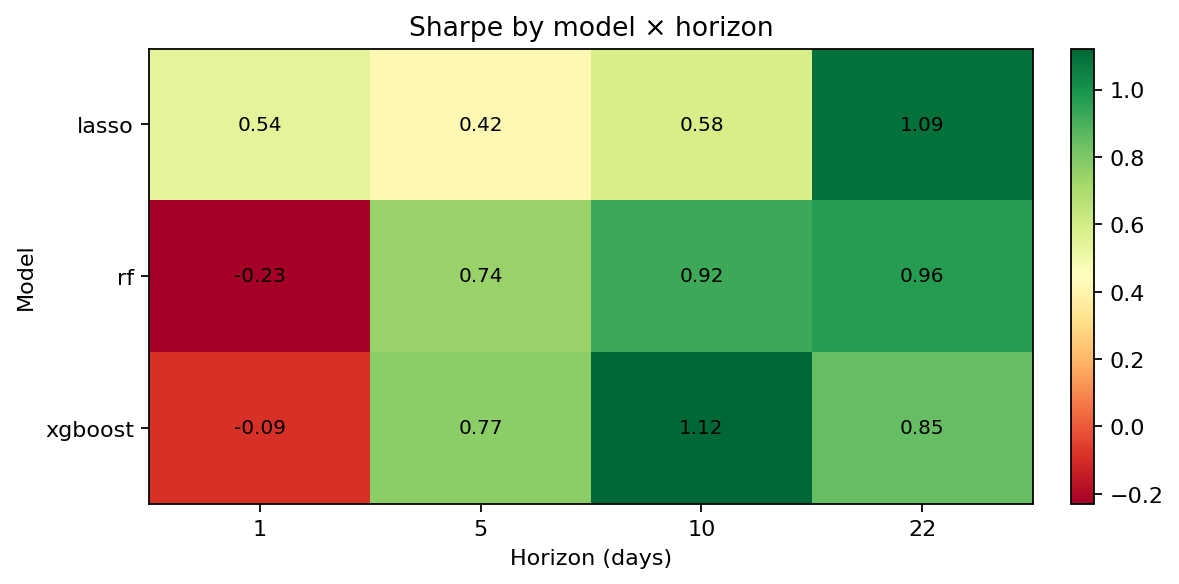
Sharpe 热力图:模型 × 预测跨度
没有常胜模型h=10 时 XGBoost 最好(1.12),h=22 时反而是 Lasso(1.09)。
h=1 两个树模型都亏RF −0.23、XGB −0.09:预测跨度越短,噪声越大。
换手是元凶h=1 年化换手 RF 336 / XGB 338,是 Lasso(125)的 2.7 倍,成本直接吃掉收益。
跨度比模型更重要同一模型跨 horizon 的差距,远大于同一 horizon 跨模型的差距。
这张表只说明「在这套口径、这段样本上」的表现,不能读成「XGBoost 天生比 Lasso 强/弱」。
8 · 收束

更复杂的模型,不等于更好的策略

Rank IC 0.091h=22 Lasso,三模型中最高
换手 81 vs 144Lasso 与 RF 的年化换手
成本 5bp每次买卖都要交,换手越高交得越多
树模型的优势要有非线性可学PCA 之后的 50 个主成分已经相当「线性」,留给树的额外空间不多。
预测准 ≠ 赚钱Rank IC 高一点,可能被更高的换手成本全部抵消;两类指标必须分开看。
选择原则能被时间验证、能说清风险的最简单方案优先;复杂模型要拿出额外收益来证明自己。
horizon=22LassoRandom ForestXGBoost
折外 Rank IC(预测得准不准)0.0910.0680.078
Sharpe(扣成本后好不好用)1.090.960.85
年化换手(要付多少成本)81144140
理解检查 · 比较模型先对齐条件

只看两个 Sharpe,能说 XGBoost 模型更强吗?

假设 XGBoost 用 Horizon=10 得到 Sharpe 1.2,Lasso 用 Horizon=22 得到 1.0;其余回测口径相同。

回答“能 / 不能”,并指出比较前要先对齐哪个参数。

先独立思考 30 秒,再点击查看答案。

查看答案收起答案
不能。模型和 Horizon 同时变了,无法把 Sharpe 差异归因于模型。先在相同 Horizon、同一时间折和成本口径下比较,再看跨 Horizon 的表现。
检查与练习 · 收尾

课后综合作业

更改参数,对比四个模型的绩效

在同一数据与时间折上运行 OLS、Lasso、随机森林、XGBoost。改变截面 Rank 选股的 Top 3 / Top 2、PCA 成分数(如 20 / 50 / 100)和预测 Horizon(如 1 / 5 / 10 / 22 日),观察四个模型在不同配置下的表现。

先逐项改变参数,再选组合对照;同一配置下四模型共享折内 PCA、交易成本与执行口径,每个 Horizon 对应 purge=Horizon。最后用一张表和净值图比较 Rank IC、年化收益、Sharpe、最大回撤、年化换手,附参数、命令与结论。